2026-10-21 · Agentic Realism
Nos données, leur calendrier
Jusqu’à sept jours pour obtenir un export ChatGPT, puis vingt-quatre heures pour le télécharger : ce qu’une installation m’a appris sur la maîtrise de notre mémoire.
L’export existe. Mais avoir des droits sur ses contenus, en obtenir une copie, la réutiliser et retrouver une continuité sont quatre choses différentes. Retour sur une difficulté très concrète, et sur ce qu’elle change dans notre façon de construire avec l’IA.
Ne pas repartir de zéro
J’ai récemment installé un agent personnel pour une personne de mon entourage. Très vite, une question pratique s’est posée : que faire de son historique ChatGPT ?
L’idée n’était pas de tout aspirer. Simplement de ne pas repartir de zéro : retrouver les échanges qui comptaient, puis choisir ensemble ce qui méritait de rejoindre le nouvel espace de travail.
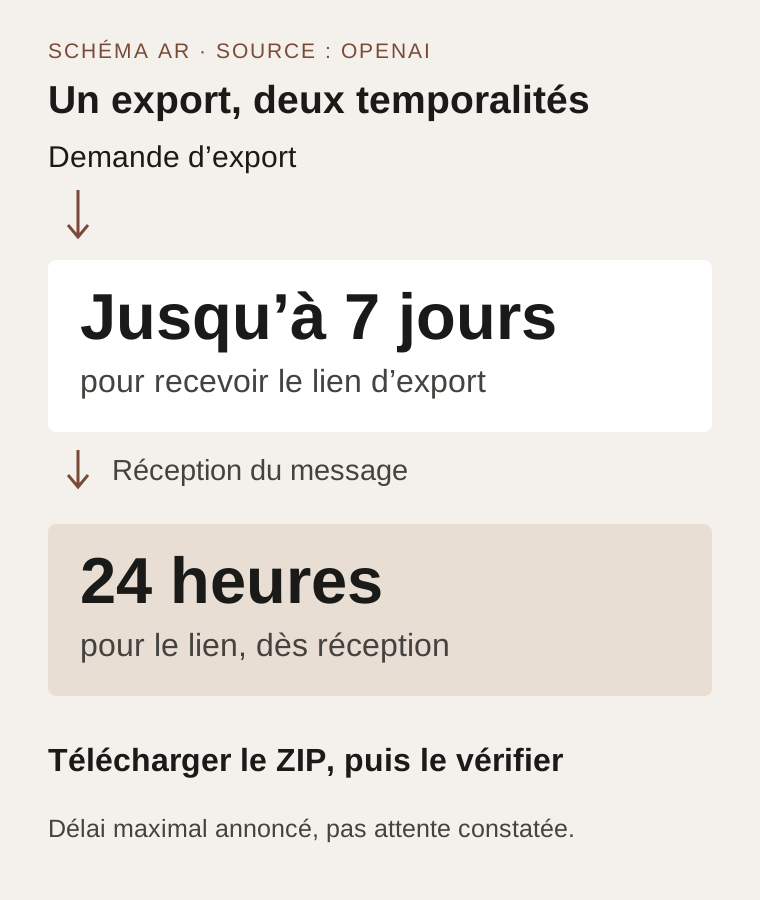
En cherchant comment récupérer cet historique, j’ai découvert la procédure d’export. La documentation d’OpenAI est claire : l’export peut mettre jusqu’à sept jours à arriver, et une fois le message reçu, le lien de téléchargement expire au bout de vingt-quatre heures.[1]
Je n’ai pas vécu une semaine d’attente : sept jours, c’est le maximum annoncé, pas un délai que j’ai mesuré. Mais lire ces deux chiffres au milieu d’une installation suffit à faire surgir une question très ordinaire : pourquoi récupérer son propre travail est-il tellement moins simple que le consulter ?
Chaque conversation est là, dans l’interface, à portée de clic. L’ensemble, pour continuer ailleurs, passe par une autre porte, qui a son propre calendrier.
C’est cet écart qui m’intéresse. Pas pour faire le procès d’un outil, mais parce qu’il révèle où se trouve réellement notre mémoire de travail.
L’export existe. La friction aussi.
Soyons précis : ChatGPT permet de récupérer ses données. OpenAI documente deux chemins : les paramètres du compte, pour les offres éligibles, et un portail de confidentialité. L’archive livrée est un fichier ZIP qui contient l’historique des conversations et d’autres données du compte.[1] Je raconte ici le chemin que j’ai trouvé et que la documentation décrit ; je ne prétends pas qu’aucune autre voie n’existe.
Mais « l’export existe » ne clôt pas la discussion. Dans les faits, il faut :
- faire la demande ;
- attendre que l’archive soit préparée, jusqu’à sept jours ;
- guetter l’e-mail ou le SMS qui l’annonce ;
- la télécharger dans les vingt-quatre heures, en étant connecté au compte qui a fait la demande ;
- ouvrir le ZIP et vérifier qu’il contient bien les conversations attendues.
Si le lien expire, il faut recommencer : nouvelle demande, nouvelle attente. Et l’export ne fait pas revenir les conversations déjà supprimées.[1]
Aucune de ces étapes n’est insurmontable. Mais chacune suppose d’être disponible au bon moment. Pour quelqu’un qui découvre ces outils, qui voyage ou qui ne relève pas ses e-mails tous les jours, une fenêtre de vingt-quatre heures n’a rien d’un détail.
Une archive de conversations peut être très sensible, et limiter la durée de vie d’un lien peut répondre à une logique de sécurité compréhensible. La documentation ne justifie pas précisément le choix de vingt-quatre heures, et je n’y vois aucune volonté de retenir qui que ce soit.
La difficulté est ailleurs. Au moment précis où l’on veut continuer autrement, on dépend encore du rythme et des règles du service qu’on utilisait jusque-là. Nos données, leur calendrier.
Ce qu’on veut emporter dépasse les messages
Prenons un cas imaginaire. Un horloger indépendant utilise une IA pour préparer sa correspondance, comparer des formulations, réfléchir à la manière de présenter une nouvelle pièce. Il ne lui confie pas ses secrets de fabrication. Pourtant, au fil des semaines, quelque chose se construit : un vocabulaire, des préférences, des corrections, la raison pour laquelle telle tournure a été écartée parce qu’elle sonnait trop commerciale.
Un échange isolé contient des phrases. Une série d’échanges raconte comment une décision s’est formée.
Autre cas imaginaire : un créateur de luminaires. Une discussion commence par une traduction, glisse vers un texte sur une œuvre, puis revient quelques semaines plus tard sur une question plus fine : comment parler de la lumière sans réduire la pièce à une fiche produit ?
Ces deux personnages sont inventés pour l’exemple ; ce ne sont pas des clients. Ils illustrent ce que nous appelons, chez Agentic Realism, le contexte vivant : les liens entre les documents, les intentions et les décisions, que l’on peut retrouver, corriger et faire évoluer.
C’est ce contexte-là que je ne voulais pas abandonner pendant l’installation. Pas un volume de texte à accumuler par principe.
Une archive n’est pas un déménagement
La documentation d’OpenAI fournit elle-même une distinction utile. Pour passer des conversations d’un compte ChatGPT à un autre, elle propose d’exporter ses données, puis de charger le fichier de conversations dans une nouvelle discussion, où il servira de référence. Elle précise que ce n’est pas une migration complète : les anciennes conversations ne réapparaissent pas une à une, la barre latérale d’origine n’est pas restaurée, et les instructions personnalisées, les mémoires et les autres réglages du compte ne suivent pas.[2]
Ce cas concerne un transfert entre deux comptes ChatGPT, pas l’installation d’un agent personnel. Mais il montre bien la différence entre accéder à un contenu et retrouver son environnement de travail.
Un ZIP peut être une excellente archive sans être une mémoire immédiatement utilisable. Le téléchargement termine une procédure ; il ne termine pas le travail de reprise.
Être propriétaire ne suffit pas à être autonome
Reste la question des droits. Les conditions d’utilisation d’OpenAI applicables en Europe, y compris en Suisse, indiquent que, dans la relation entre l’utilisateur et OpenAI et dans les limites du droit applicable, l’utilisateur conserve ses droits sur ce qu’il fournit et possède ce que le service produit.[4]
C’est une clause contractuelle, pas une garantie universelle. Les mêmes conditions rappellent qu’une réponse peut ne pas être unique, d’autres utilisateurs pouvant recevoir des sorties similaires, et qu’OpenAI peut utiliser les contenus pour fournir, maintenir, développer et améliorer ses services.[4] « Posséder » ne signifie donc ni exclusivité sur une formulation, ni usage réservé à soi seul.
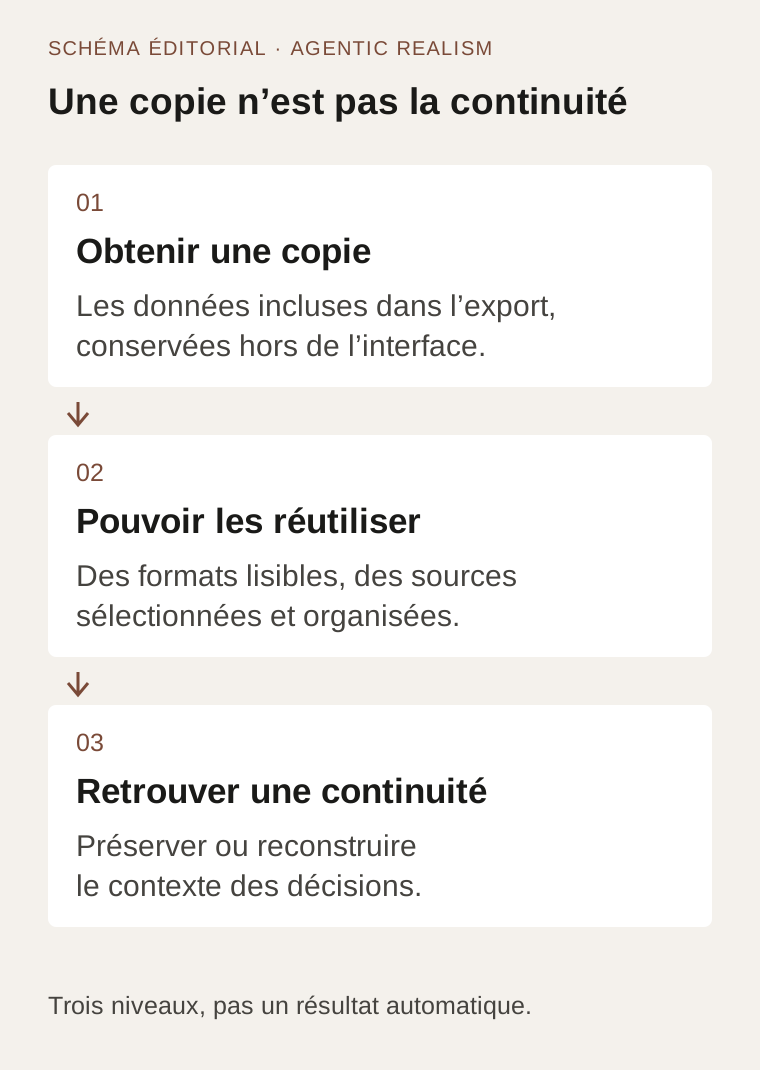
Surtout, la propriété ne répond pas à la question que pose mon installation : de quels moyens disposons-nous réellement pour reprendre notre travail ? Quatre niveaux se superposent sans se confondre :
Avoir des droits → ce que le contrat et la loi reconnaissent sur les contenus.
Obtenir une copie → recevoir effectivement les fichiers.
Pouvoir les réutiliser → les lire, les trier, les organiser.
Retrouver une continuité → relier sources, décisions et projets dans un nouvel espace.
Grille de lecture proposée par Agentic Realism ; elle ne décrit pas le fonctionnement interne de ChatGPT.
On peut être solidement établi au premier niveau et buter sur chacun des suivants.
Une dernière confusion à lever : la portabilité n’est pas la même question que l’entraînement des modèles. OpenAI propose un réglage qui exclut les nouvelles conversations de l’entraînement, sans les retirer de l’historique. Avec une exception à connaître : si l’on donne volontairement un retour, par exemple un pouce levé ou baissé, toute la conversation associée peut servir à l’entraînement.[3] Ce réglage encadre un usage des données ; il ne dit rien de la facilité à partir.
« Confidentiel », « à moi » et « récupérable » sont trois promesses différentes. Aucune ne garantit les deux autres.
Garder un espace à soi, sans renoncer aux bons outils
Je n’en conclus pas qu’il faut cesser d’utiliser ChatGPT. On peut apprécier un service et regarder lucidement la dépendance qu’il installe dans notre façon de travailler. OpenAI l’écrit d’ailleurs dans ses conditions : l’entreprise ne s’engage pas à proposer ses services indéfiniment, ni sous leur forme actuelle.[4] C’est une précision honnête. C’est aussi une bonne raison de ne pas confier à un seul historique toute la continuité d’un projet.
La réponse que nous cherchons à construire est concrète. Après une séance de travail utile, on garde dans un espace choisi le texte validé, les références nécessaires, la décision prise et ce qui reste à vérifier. L’historique de conversation reste une source parmi d’autres ; il ne porte plus seul la mémoire du projet.
Un agent peut aider à tenir cet espace : retrouver une source, préparer le contexte d’une tâche, signaler ce qui manque. Il ne devrait pas décider seul d’y importer toute notre histoire.
Car tout rapatrier n’est pas toujours souhaitable. Un historique peut contenir des confidences, des informations sur d’autres personnes, des essais abandonnés, des réponses fausses. Il faut pouvoir trier, exclure, corriger. Une ancienne réponse du modèle ne devient pas un fait parce qu’elle figure dans une archive.
Cette exigence vaut aussi pour ce que nous construisons. Installer un agent sur une machine dédiée ne rend pas un système confidentiel ou autonome par nature. Il faut encore savoir qui y accède, où vont les sauvegardes, quels formats sont utilisés, quels traitements passent par des services extérieurs, et comment on quitte le dispositif.
La personne pour qui j’ai installé cet agent doit pouvoir s’en passer un jour, emporter ses fichiers et continuer sans nous, sans dépendre de notre calendrier. La possibilité de partir doit exister aussi vis-à-vis de nous. Sinon, nous n’aurions fait que déplacer la dépendance.
Tester la sortie avant d’en avoir besoin
Pour une personne ou un atelier, un premier exercice peut rester très simple. Choisir un projet sans enjeu sensible. Rassembler ses sources et ses décisions dans un dossier que l’on maîtrise. Puis essayer de le reprendre sans rouvrir l’ancien compte de conversation.
Les fichiers sont-ils lisibles ? Les décisions, compréhensibles ? Distingue-t-on ce qui a été validé de ce qui n’était qu’une proposition ? Un autre outil peut-il aider à continuer, sans prétendre ressusciter l’ancien assistant à l’identique ?
Ce test vaut mieux qu’une grande promesse de souveraineté. Il montre ce qui manque pendant qu’il est encore temps de s’organiser.
L’export proposé par une plateforme reste précieux : mieux vaut le demander, le télécharger à temps et le conserver avec soin le jour où l’on en a besoin. Mais la continuité peut aussi se construire au fil du travail, plutôt que se révéler fragile le jour d’un changement.
Au bout du compte, cette installation tient en une question élémentaire : quand on confie du travail à une IA, où en garde-t-on la mémoire ?
Nous voulons des outils capables de nous accompagner longtemps. Nous voulons aussi pouvoir continuer sans eux.
Documentation consultée le 21 octobre 2026 ; les fonctions et conditions des services peuvent évoluer. Cet article distingue une expérience rapportée, les procédures documentées par OpenAI et une proposition de méthode d’Agentic Realism. Il ne constitue pas un avis juridique et ne mesure pas les délais réellement constatés par les utilisateurs.
Sources
- [1] https://help.openai.com/en/articles/7260999-how-do-i-export-my-chat-history-and-data — Exporting your ChatGPT history and data | OpenAI Help Center
- [2] https://help.openai.com/en/articles/9106926-transferring-conversations-from-1-chatgpt-account-to-another-chatgpt-account — Transfer exported conversations between ChatGPT accounts | OpenAI Help Center
- [3] https://help.openai.com/en/articles/7730893-data-controls-faq — Data controls in ChatGPT | OpenAI Help Center
- [4] https://openai.com/policies/eu-terms-of-use — Europe Terms of Use | OpenAI